Meta de EE. UU. lanza un modelo de IA de pesos abiertos con 816 000 millones de parámetros que permite su ejecución local en ordenadores Apple
es.wedoany.com Noticia: El 15 de octubre, la empresa tecnológica estadounidense Meta lanzó oficialmente el modelo de inteligencia artificial de pesos abiertos Muse Spark Open, con un total de 816 000 millones de parámetros, 42 000 millones de parámetros activos y una ventana de contexto de 1 millón de tokens. El modelo está diseñado para el desarrollo de software complejo, el razonamiento de múltiples pasos y tareas de agentes de inteligencia artificial, y está optimizado para el chip Apple M5 Ultra, lo que permite su despliegue local mediante dos estaciones de trabajo Mac Studio.
Muse Spark Open adopta una arquitectura multimodal nativa y puede ejecutar programación de flujo largo, ingeniería de software y procesamiento autónomo de tareas. Meta ha integrado el modelo en su terminal de programación de inteligencia artificial Muse Code y ha completado múltiples pruebas de ejecución local, incluyendo la corrección de errores de programa, el desarrollo de nuevas funciones y la compilación completa de software en el cliente de código abierto Mastodon Ice Cubes, así como el análisis fotograma a fotograma de material, la selección de fragmentos y el recorte vertical mediante el software de edición de vídeo DaVinci Resolve.
En cuanto a la adaptación de hardware, el modelo se ejecuta mediante el marco de aprendizaje automático Apple MLX. Una sola Mac Studio equipada con el chip M5 Ultra puede configurarse con hasta 512 GB de memoria unificada, y la combinación de dos dispositivos proporciona una capacidad de memoria de aproximadamente 1 TB. El ancho de banda de memoria del chip M5 Ultra alcanza los 1,2 TB/s, lo que puede satisfacer las necesidades de lectura de datos durante la inferencia del modelo.
Meta también ha realizado optimizaciones de inferencia para diferentes arquitecturas de chips, y el modelo es compatible con marcos de inferencia como SGLang, vLLM, TensorRT-LLM y Apple MLX. En las unidades de procesamiento gráfico de NVIDIA y AMD, los núcleos GPU Helion personalizados logran una aceleración a nivel de núcleo de 1,03 a 3,95 veces, y la plataforma AMD MI350 mejora el rendimiento de inferencia de extremo a extremo en aproximadamente un 3 %.
Los pesos del modelo Muse Spark Open ya están disponibles para su descarga a través de Hugging Face, Amazon SageMaker AI, Google Cloud Model Garden y Microsoft Foundry Models, y también se han integrado en plataformas de servicios de inferencia como Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter y Together AI. El modelo utiliza la licencia Muse Model License, que permite a los desarrolladores usarlo y personalizarlo bajo términos comerciales limitados.
Productos relacionados

Conmutador rápido de fuente de alimentación redundante QPS-20A
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.
Terminal satelital portátil de placa plana de 0,35 m de diámetro (manual)
China Starwin Science & Technology co., Ltd.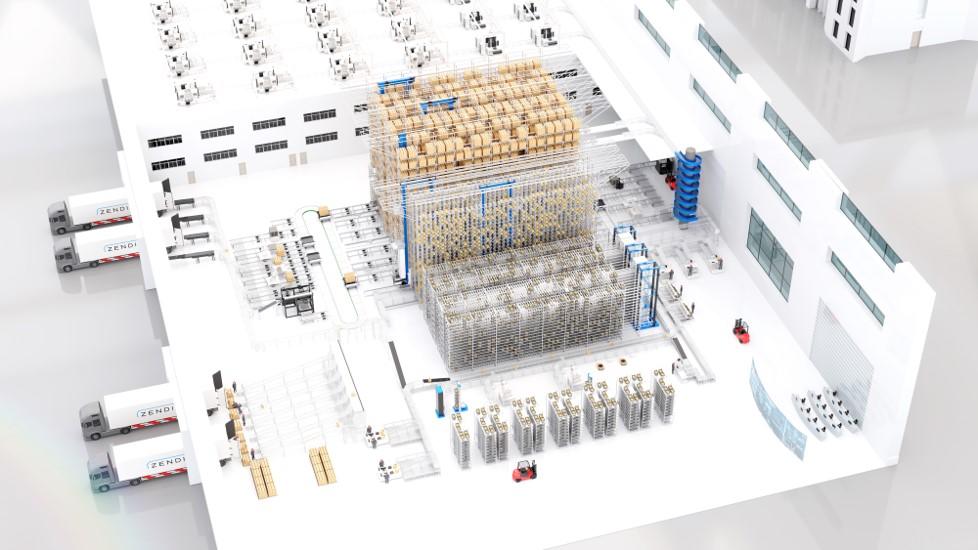
Servicio integral de gestión de cadena completa para la integración de sistemas logísticos
Zhongding Intelligent (Wuxi) Technology Co., Ltd.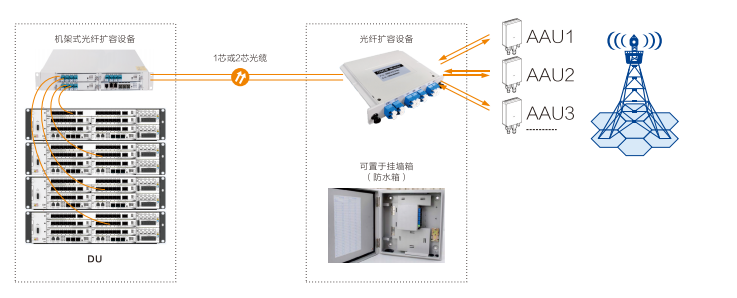
Productos de sistemas de multiplexación por división de longitud de onda (WDM)
Shenzhen SDG Information Co., Ltd.
TWP16 Radar de perfil de viento troposférico en banda P
China Huayun Meteorological Technology Group Co., Ltd.