
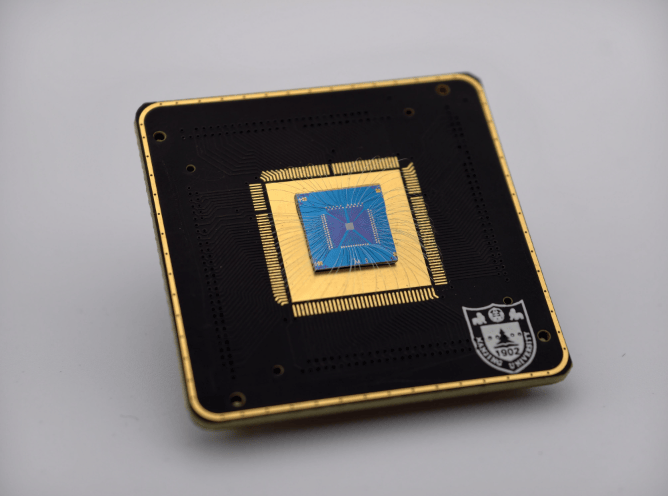
Cómo lograr de manera eficiente y con bajo consumo energético la adquisición sincrónica y la tokenización de la información visual es un desafío clave que el hardware de inteligencia artificial (IA) física debe resolver urgentemente. Recientemente, el equipo de los profesores Miao Feng y Liang Shijun de la Universidad de Nanjing, en colaboración con el equipo de la Universidad Nacional de Singapur, desarrolló por primera vez a nivel internacional un chip sensor de visión inteligente de ultra bajo consumo, denominado "Guangyu Xin" (Chip de Luz y Lenguaje), capaz de convertir directamente la luz en tokens. Los tokens generados por este chip pueden introducirse directamente en un codificador para lograr el reconocimiento de imágenes. Los resultados de la investigación se publicaron en línea el día 19 en la revista académica internacional Nature Sensing.
La capacidad de percepción autónoma, razonamiento y toma de decisiones de la IA física en entornos complejos depende en gran medida de la capacidad de los dispositivos de borde para ejecutar eficientemente grandes modelos de visión. Sin embargo, los dispositivos de borde, limitados por el consumo energético y la potencia computacional, difícilmente pueden realizar el reconocimiento visual en tiempo real de manera local.
"En la cadena tradicional de percepción visual, la señal de luz debe pasar por múltiples procesos, como la captura por el sensor de imagen, la conversión analógico-digital, el transporte de datos en caché, la división digital en bloques y la incrustación, antes de generar tokens procesables por el modelo. El transporte frecuente de grandes volúmenes de datos redundantes provoca un consumo energético persistentemente alto en el borde", explicó Miao Feng. "Nuestra intención es completar la tokenización directamente en el sensor, evitando esta ruta desde el nivel físico".
En esta investigación, el equipo propuso por primera vez a nivel internacional trasladar el proceso de generación de tokens al sensor, completando directamente en el sensor funciones como la captura de imágenes, la división en bloques y la incrustación de bloques de imagen.
Liang Shijun indicó que el chip "Guangyu Xin" desarrollado por el equipo está compuesto por una matriz de almacenamiento fotosensible y circuitos de direccionamiento periférico. El equipo construyó primero una matriz de almacenamiento fotosensible basada en fototransistores de puerta flotante de disulfuro de molibdeno monocapa. Cada píxel de la matriz combina tres funciones: fotosensibilidad, almacenamiento y cálculo analógico. Tras la escritura de la señal de luz, esta se conserva in situ en forma de carga de puerta flotante. Los circuitos de direccionamiento periférico pueden activar selectivamente regiones de píxeles para completar la división de la imagen en bloques. Para los bloques de imagen seleccionados, el chip aplica además una secuencia específica de voltajes, de modo que la información de luz almacenada en el bloque de imagen y la matriz de incrustación realicen operaciones de multiplicación y acumulación en el dominio analógico, y la corriente de salida constituye el token.
"Hemos logrado en el chip el cálculo físico de 'entra la luz, sale directamente el token', eliminando de raíz el transporte de datos, que es la mayor fuente de consumo energético", explicó Liang Shijun. Este método de "tokenización física" transforma el chip de un registrador pasivo de imágenes a un generador activo de semántica visual. La tasa de precisión de reconocimiento del sistema de arquitectura de conversión visual basado en "Guangyu Xin" alcanza el 87,3%, cercana a la línea base de reconocimiento del software tradicional, y en comparación con los esquemas convencionales, la eficiencia energética en la etapa de tokenización mejora más de 10 veces.
Miao Feng señaló que este logro subvierte fundamentalmente el paradigma secuencial de "primero fotosensibilizar, luego almacenar en caché y finalmente calcular", abriendo una nueva dimensión para superar el techo de la potencia computacional y el consumo energético de la IA de borde en la era post-Moore. Se espera que esta tecnología proporcione una base de cognición visual de alta eficiencia energética y latencia casi nula para campos como la inteligencia encarnada, los drones de baja altitud y la seguridad inteligente, acelerando la aplicación a gran escala de la IA física.